
GitHub 最近在控制台页面上方弹出一项公告:「On April 24 we’ll start using GitHub Copilot interaction data for AI model training unless you opt out. Review this update and manage your preferences in your GitHub account settings.」。简单来说,他们将在 4 月 24 日强行启动一项「代码收割」计划:除非你手动拒绝,否则你的私有开发数据将默认成为训练下一代 AI 的燃料。
这项更新跳过了协商阶段,直接把「默认同意」塞给所有个人版使用者。这不仅是隐私条款的变动,更是开发工具对开发者数字主权的公然越权。当你写下的每一行业务逻辑、每一次对补全建议的修正都被记录并回传,你其实是在无偿为微软与 OpenAI 的商业模型提供高阶对齐校准服务。
保护你的代码资产,重点在于 Settings > Copilot 页面中的两个关键开关,它们决定了你的数据流向与法律边界:
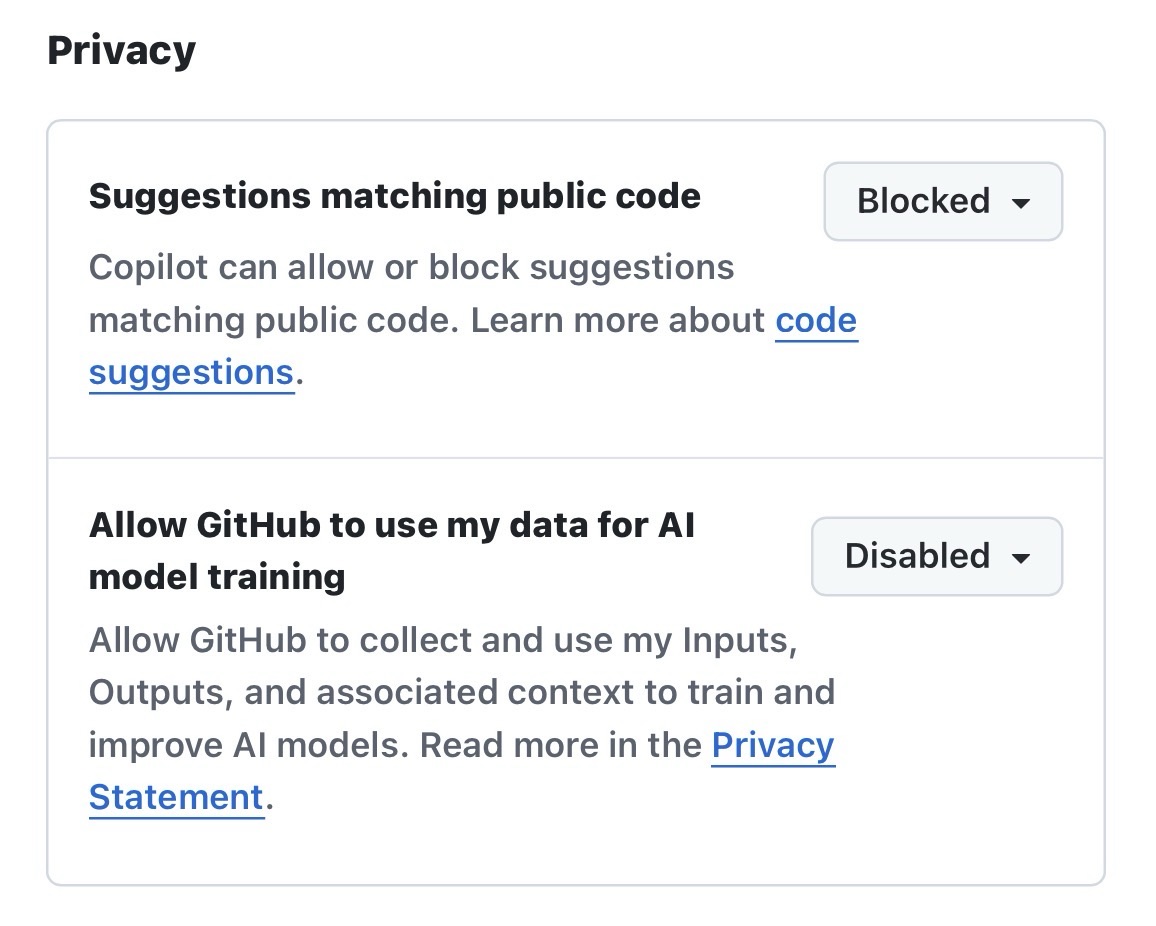
GitHub Setting: Privacy
首先,关掉「Allow GitHub to use my data for AI model training」。
这是最核心的红线。开启它,等于允许 GitHub 采集你的 Inputs(输入的原始代码、上下文) 与 Outputs(AI 生成的建议)。
虽然官方声称会进行去标识化处理,但 AI 模型本质上是一个难以预测的黑盒子。没人能保证你的商业机密或独特算法,不会在未来的某个时刻,以「代码补全」的形式出现在竞争对手的编辑器里。
其次,将「Suggestions matching public code」设置为 Block。
这是一个法律防火墙。这个开关负责拦截那些与 GitHub 公开代码高度重合(超过 150 字符)的建议。
如果你不小心接受了这类片段,你的项目极可能在无意间引入了 GPL 等具有强迫开源性质的传染性授权协议,埋下日后法律诉讼的地雷。将其设为 Block,是资深开发者避开开源协议授权陷阱的基本修养。
主动调整这些设置并非排斥 AI,而是在工具与创作者之间重新划定界线。当商业公司试图透过默认选项来收割开发者的劳动成果时,手动说「不」,是我们在这场自动化浪潮中保持独立性的最低成本。在 4 月 24 日期限到来前,请花五分钟检查你的账号权限。
以实际行动支持独立观点,与我们一同走得更远
每一篇条理清晰的分析、每一次不随波逐流的观察,背后都是对真实与品质的坚持。我们拒绝内容农场与算法流量绑架,坚持自由独立的客观发声。
维持高品质的原创写作与独立运营,需要持续的实质力量。您可以选择一次性赞助或每月定期支持,通过 Google 安全结账,与我们一同守护这份深刻与清醒。
由 Google 安全处理付款 · 可随时在 Google 账户管理或取消

留言板