
Webサイトをスパムボットの攻撃や不正アクセスから守るための認証技術は、インターネットの黎明期から存在していました。最初期の歪んだ英数字の読み取りから始まり、単語認識、画像認識へと発展を遂げてきましたが、プログラム側の画像解析技術(いわゆる自動化ボット)の進化とのいたちごっこが続いてきました。
そんな中、Google は数年前に画期的な人間認証技術「Google reCAPTCHA」をリリースしました。マウスカーソルを動かしたり指でタップしたりして、指定されたチェックボックス(下の画像を参照)を1回クリックするだけで、人間であることを簡単に判別してくれます。人間の肉眼ですら判読困難だった従来の歪んだ文字認証に比べてはるかに快適で、瞬く間に世界中のWebサイトで採用されることとなりました。皆さんも日常的に目にしているあの「私はロボットではありません」のチェックボックスです。
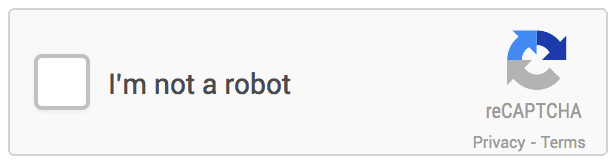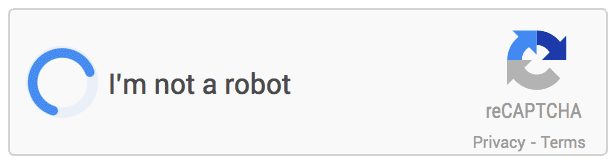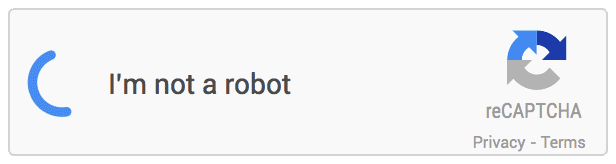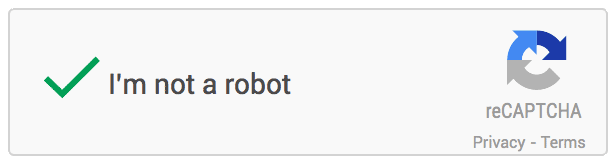
Google のチェックボックス式認証技術
しかし実は、Google のボット認証システム「reCAPTCHA」には複数のセキュリティレベルが存在します。最も手軽なチェックボックス認証だけでなく、サイト管理者の設定やアクセスの不審度に応じて、より複雑な画像認証画面が表示される仕組みになっています(下の画像を参照)。
この画像認証に遭遇した場合、自分がロボットでないことを証明するために、9分割などのグリッド画像の中から指定されたオブジェクト(「信号機」、「バス」、「自動車」、「横断歩道」、「看板」など)が写っているパネルをすべて選び出さなければなりません。
Google の画像認証に対しては、ユーザーを無報酬で動員してAI(人工知能)の学習データを収集させているのではないかという批判が以前から根強く存在します。特に交通標識や車両の画像が多用されていることから、次世代の自動運転AIの画像認識アルゴリズムの教師データとして利用されているのではないかと囁かれています。
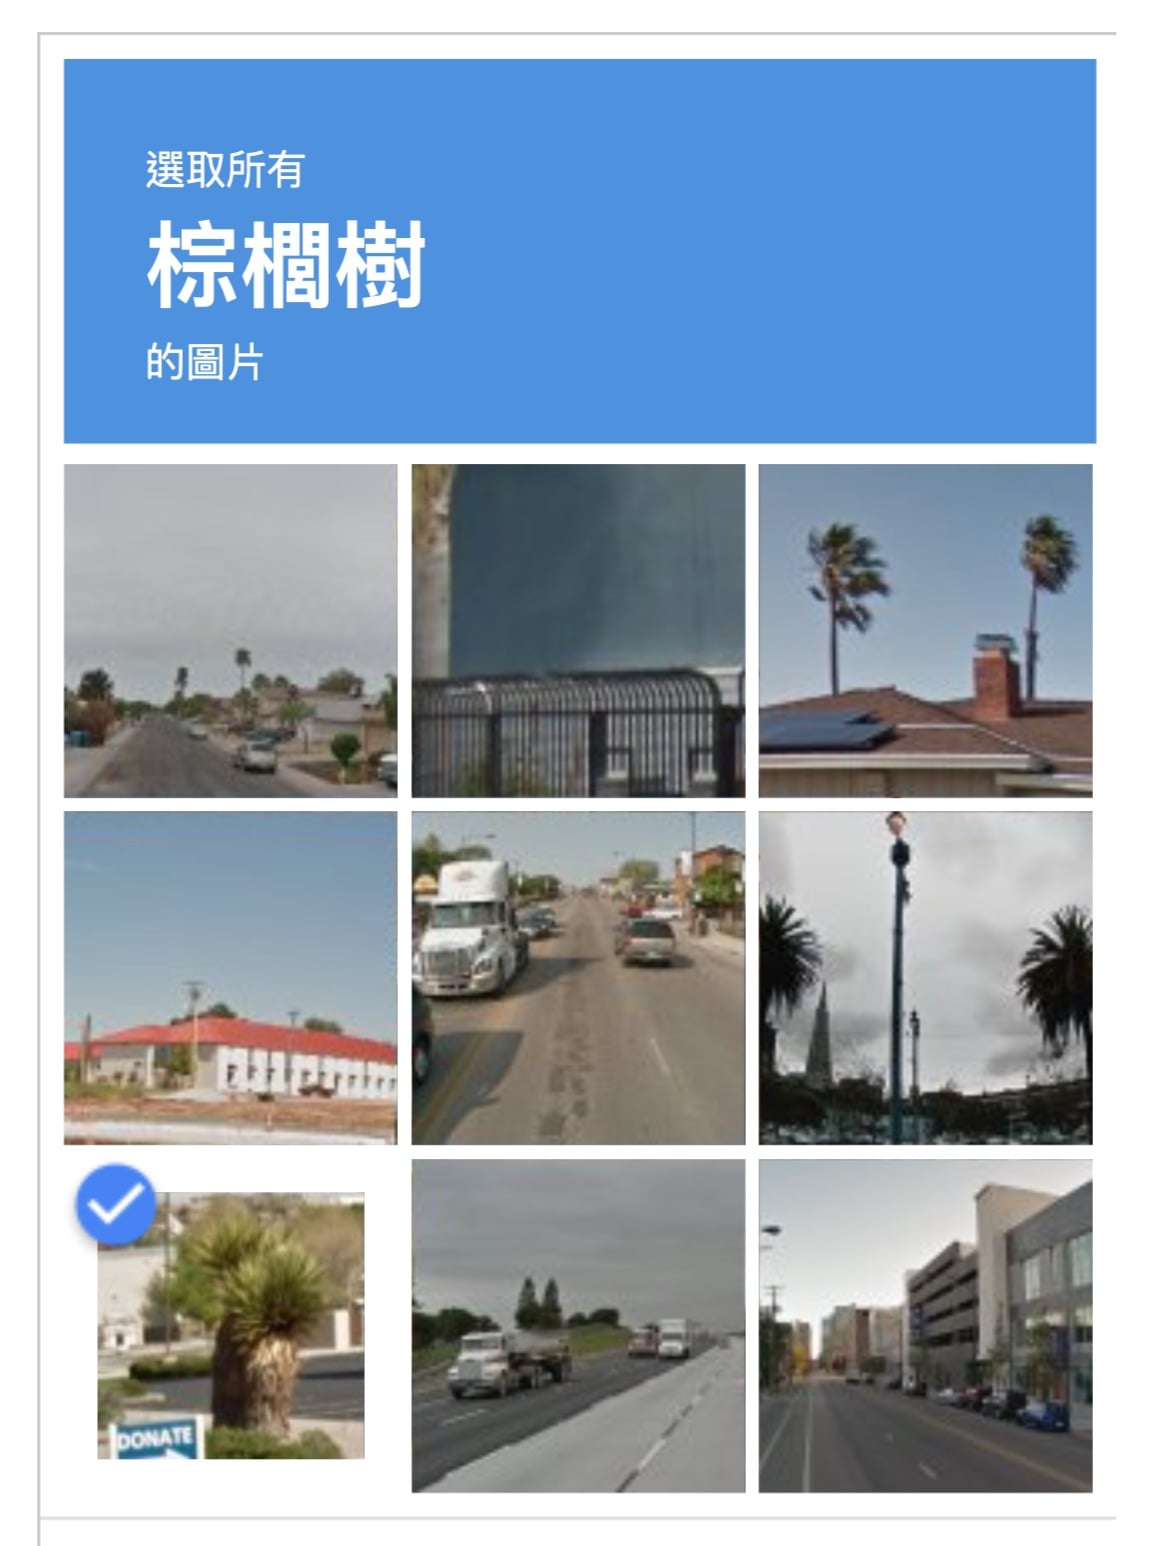
……ちょっと待ってください。「ヤシの木が写っているタイルをすべて選択してください」ってどういうことでしょうか?
こんな小さな不鮮明なサムネイル画像の中で、どれが本物のヤシの木でどれが似た別の木なのか、専門家でもなければ見分けがつくはずもありません。そもそも文字を入力する段階ですら漢字の変換に迷うレベルなのに、並んだ写真の樹木はどれも似ているようであり、同時にどれも微妙に違って見えます。一体どう選べというのでしょうか?
(私が最初に選んだ画像、どう見てもソテツ(蘇鉄)だった気がするのですが……?)
Google のこの画像認証は、本当に「人間であること」を確認しているのでしょうか。それともユーザーの知能指数(IQ)を試して遊んでいるのでしょうか?💢💢💢
独自の視点と客観的な報道を、あなたの温かい支援で
表面的なトレンドやアルゴリズムに流されず、事実と深い洞察に基づいた独立した記事をお届けし続けるために。
質の高いオリジナル記事と独立した運営を続けるため、1回のみ、または毎月のご支援をGoogleの安全な決済でお願いいたします。
お支払いはGoogleにより安全に処理されます · いつでも管理・解約できます

コメント