
GitHub のダッシュボード上に最近、次のような通知が表示されました:「On April 24 we’ll start using GitHub Copilot interaction data for AI model training unless you opt out. Review this update and manage your preferences in your GitHub account settings.」。端的に言えば、4月24日以降、ユーザーが自らオプトアウト(拒否)しない限り、個人の開発データが次世代AIモデルの学習データとしてデフォルトで収集されることになります。
事前の合意形成を省き、個人ユーザーに「デフォルト同意」を押し付けるこの更新は、開発者のデジタル主権に対する過度な介入と言えます。あなたが記述したビジネスロジックや補完に対する修正履歴が記録・送信されることは、マイクロソフトやOpenAIの商用モデルに無償で高度なファインチューニングデータを提供しているのと同じです。
自身の知的資産とコードを守るため、アカウント設定の Settings > Copilot 画面で確認すべき2つの重要スイッチを解説します:
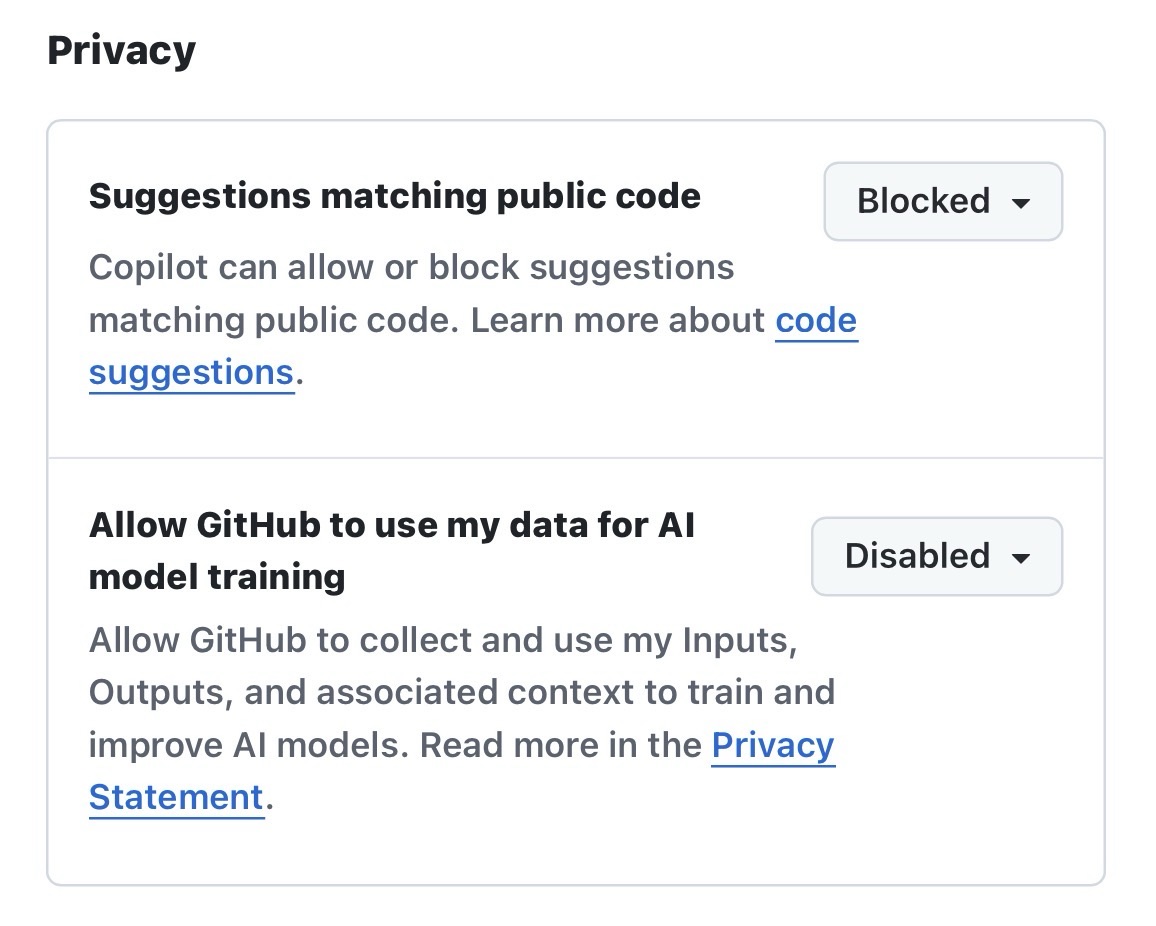
GitHub 設定画面:プライバシー項目
まず、1つ目の設定「Allow GitHub to use my data for AI model training」をオフにします。
これが最も重要な防壁です。この項目が有効になっていると、GitHub は入力コードやコンテキストを含む Inputs、およびAIが生成した補完案である Outputs の双方を収集できるようになります。
公式には匿名化処理を行うと主張されていますが、大規模AIモデルは本質的に予測困難なブラックボックスです。独自のアルゴリズムや社外秘のロジックが、将来競合他社のエディタで「補完候補」として出現しないという保証はどこにもありません。
次に、「Suggestions matching public code」を Block に設定します。
これは法的なファイアウォールとして機能します。GitHub 上のパブリックコードと高度に重複(150文字以上)する提案をブロックするためのスイッチです。
万が一、GPLなどの強力なコピーレフト条項を持つコード断片を無自覚に取り込んでしまった場合、プロジェクト全体がライセンス違反の法的係争に巻き込まれる恐れがあります。これを Block に指定することは、プロの開発者としてライセンス汚染からリポジトリを守るための必須マナーです。
こうした設定を見直すことは、AIの利便性を否定するものではなく、道具と創作者の間に明確な境界線を引くための健全な行動です。プラットフォーマーがデフォルト設定を利用して開発者の成果物を囲い込もうとするとき、手動で「No」を突きつけることは、自律性を保つための最低限の防衛策です。4月24日の期限を迎える前に、必ず設定を確認しておきましょう。
独自の視点と客観的な報道を、あなたの温かい支援で
表面的なトレンドやアルゴリズムに流されず、事実と深い洞察に基づいた独立した記事をお届けし続けるために。
質の高いオリジナル記事と独立した運営を続けるため、1回のみ、または毎月のご支援をGoogleの安全な決済でお願いいたします。
お支払いはGoogleにより安全に処理されます · いつでも管理・解約できます

コメント